Analyse du Nutri-Score
2026 · Projet de Master 1 Data Science en Santé · travail de groupe (5 étudiants)
Analyse du Nutri-Score et des nutriments des produits alimentaires en France
À partir des données Open Food Facts · tableau de bord interactif en Python
Projet de groupe · 5 personnes
Question : comment l’analyse des nutriments permet-elle d’expliquer les différences de Nutri-Score entre les produits ? L’objectif était de créer un outil que tout le monde peut comprendre, même sans connaissances en nutrition.
1,2 M de produits
~250 variables
3 pages interactives
Ce que nous avons fait
Préparer les données
La base d’origine pesait environ 12 Go. Nous l’avons nettoyée sur Google Colab : valeurs manquantes, taux de nutriments impossibles (plus de 100 g pour 100 g) et séparation en plusieurs fichiers plus légers.
Créer nos propres catégories
La base contenait environ 200 catégories très différentes, en français et en anglais. Nous avons écrit un dictionnaire de mots-clés et l’avons amélioré en 8 tours, pour que les produits soient répartis dans des familles claires (boissons, produits laitiers, féculents…).
Construire un tableau de bord
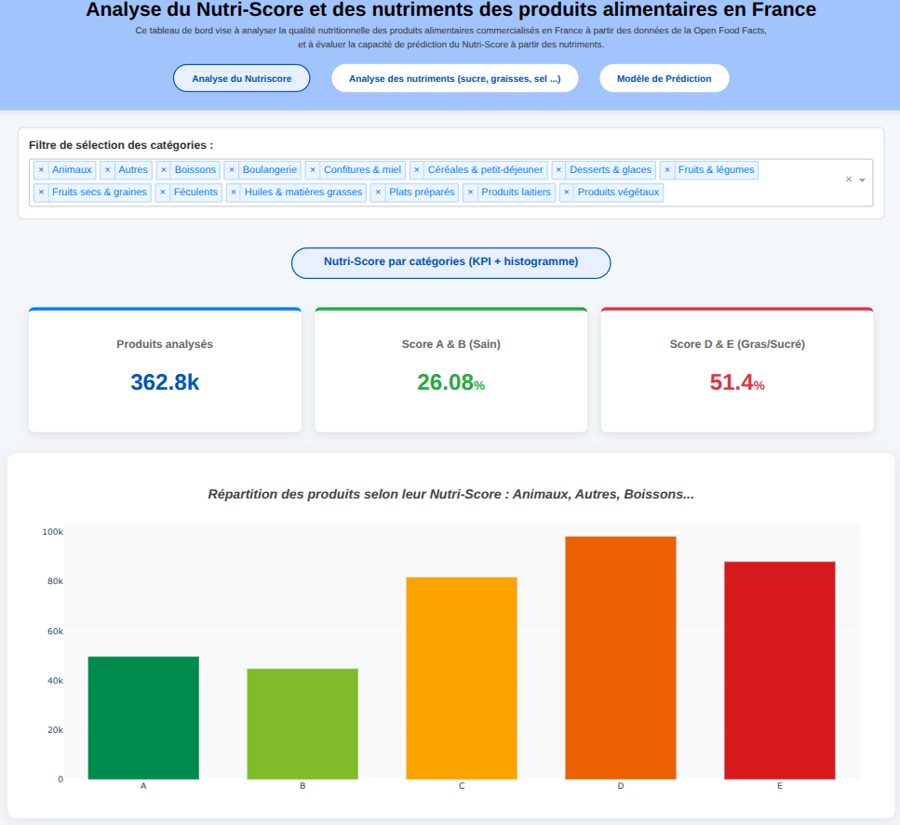
Trois pages : l’analyse du Nutri-Score par catégorie, l’analyse des nutriments (sucre, graisses, sel, fibres, protéines) et un modèle de prédiction du Nutri-Score.
Prédire le Nutri-Score
Environ 60 % des produits n’ont pas de Nutri-Score. Nous avons entraîné une régression logistique qui l’estime à partir des valeurs nutritionnelles saisies par l’utilisateur.
Mettre l’outil en ligne
Nous avons déployé l’application sur Render et partagé le code sur GitHub, avec des instructions pour refaire les analyses.
Ce que nous avons observé
Le sucre, le sel et les graisses saturées expliquent une grande partie des mauvais Nutri-Scores. À l’inverse, les produits peu transformés (fruits et légumes, féculents, produits végétaux) sont les mieux notés. Le Nutri-Score est surtout utile pour comparer des produits d’une même catégorie.
Outils utilisés
PythonpandasnumpyDashPlotlyscikit-learnjoblibGoogle ColabGitHubRenderR (exploration)